Demo
€030 giorni
Installi lo stack completo sul tuo server e lo provi con i tuoi carichi reali. Poi passi alla licenza senza reinstallare.
Installa la demoVentic è un prodotto: paghi una licenza mensile, per host o per azienda, sulla tua infrastruttura. La licenza non dipende dai token; il consumo dei modelli è credito prepagato che governi per gruppo e per chiave.
Ventic si acquista come licenza software mensile, per host o per azienda, con gli stessi prezzi di Licman. Prezzi in EUR, IVA esclusa, impegno di un mese.
Installi lo stack completo sul tuo server e lo provi con i tuoi carichi reali. Poi passi alla licenza senza reinstallare.
Installa la demoUna licenza per ogni host su cui gira Ventic. Ideale per partire con uno o due server.
Acquista su LicmanTutti gli host dell'azienda sotto un'unica licenza. Conviene quando la flotta cresce.
Acquista su LicmanPrezzi iniziali in EUR, IVA esclusa, aggiornati al 28 ottobre 2026. Le modifiche valgono per le nuove richieste; offerte e abbonamenti già concordati mantengono il loro importo. Demo gratuita di 30 giorni. Cerchi un servizio gestito? È venduto a parte su llm.netter.io.
| Criterio | Subscription frontier | Pagamento a token | Ventic On Premise |
|---|---|---|---|
| Costo prevedibile a fine mese | Canone fisso | Dipende dal consumo | Licenza fissa; il consumo AI è credito prepagato a parte |
| Controllo della spesa | Per account, poco visibile | Dashboard del provider | Quote per gruppo, limiti per chiave, riserva prima di ogni richiesta |
| Dove passa il dato | Sui server del provider | Sui server del provider | Lo decidi per modello: cloud o runtime locale, PII opzionale |
| Scelta dei modelli | Quelli del provider | Catalogo del provider | DeepSeek, OpenRouter e runtime tuoi, con alias stabili |
| Stabilità del modello nel tempo | Cambia senza preavviso | Dipende dal provider | Alias stabili; sui runtime locali i pesi li governi tu |
| Continuità durante un outage | Ti fermi con loro | Ti fermi con loro | Con più target equivalenti e routing failover |
| Audit e contabilità | Non prevista | Report del provider | Ledger bilanciato, registro attività, export |
| Più aziende e rivendita | No | No | Tenant, reseller e commissioni |
| Infrastruttura | Non serve | Non serve | Un cluster Kubernetes tuo; GPU solo per i modelli locali |
Il dimensionamento parte dalle persone e dalle applicazioni che lavorano insieme e dai modelli che vuoi servire, non dai token. Ogni VM di un deployment gestito ospita una replica completa del modello.
Agenti di coding e app usano gli SDK OpenAI o Anthropic di sempre. Cambiare modello non tocca il codice.
Regole per team, tipo di richiesta, PII e budget: così il 90% del traffico va sui modelli open.
Noleggi GPU o accendi il server locale con venticli apply. Autoscaling e spegnimento fuori orario inclusi.
L'agent si collega in uscita: niente IP pubblico né VPN. Il server in ufficio è un target come gli altri.
PII mascherate in modo reversibile e regole di residenza: le richieste con dati personali restano in locale.
Budget riservato prima di ogni richiesta. Se un target è lento o giù, la regola passa al successivo.
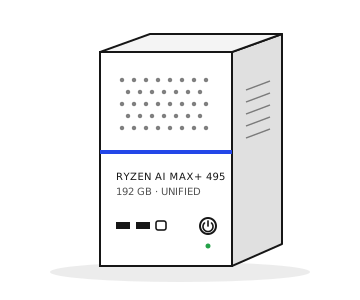
Ryzen AI Max+ 495 con 192 GB di memoria unificata: modelli open per un team di sviluppatori, sotto la scrivania.
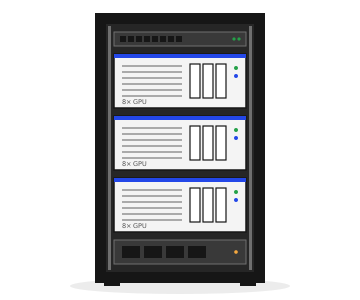
Nodi multi-GPU nel tuo datacenter per tutta l'azienda: Ventic li gestisce come un unico compute pool, con autoscaling.
I setup migliori per il tuo hardware, sempre aggiornati.
Ti forniamo le configurazioni di inferenza già ottimizzate per le tue macchine, così sfrutti al massimo ogni GPU. Per i modelli open weight più recenti curiamo il fine tuning dei parametri di serving sui principali motori di inferenza: quantizzazione, parallelismo, batching, cache KV e contesto.
Un canone per ogni configurazione hardware diversa da coprire. Il servizio è opzionale: Ventic funziona anche senza.
Ryzen AI Max+ PRO 495, 192 GB. Pronto per Ventic.
Listino del produttore, IVA da confermare. Circa 6 sviluppatori per server; rientro in 17 mesi sul piano da $100.
Richiedi il server su CompudUn’ora per capire che cosa vuoi governare, quali modelli servono e dove devono girare.